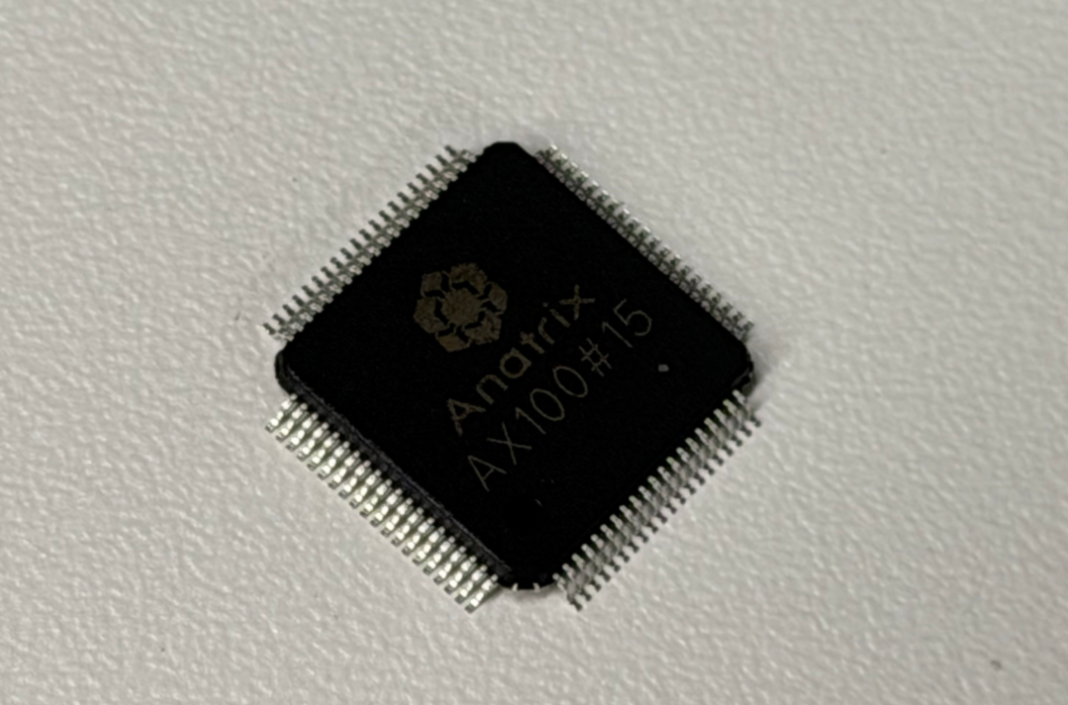

根據《科技日報》報導指出,中國晶片技術再傳重大突破!模擬計算晶片公司安納智芯自主研發的AX100晶片,已於2026年10月完成流片,成為全球首顆全集成、一步求解矩陣方程的模擬計算晶片。經測試,AX100單次矩陣方程求解時間不到100奈秒,單次計算功耗約80毫瓦,性能符合原先理論模擬與設計預期,有望為人工智慧、機器人及無線通信等領域帶來新的運算方案。
目前AI大型語言模型訓練、機器人動作控制、空間規劃,以及通信基地台訊號處理等技術,都需要大量矩陣方程運算。傳統數位晶片主要透過大量乘加運算與反覆迭代完成計算,隨著矩陣規模增加,運算負擔也大幅提升。相較之下,模擬計算能直接利用物理定律實現平行運算,具有低延遲、低功耗優勢。
安納智芯執行長向銳表示,AX100將矩陣方程直接映射為電路,透過電路自我平衡,一次讀取計算結果,不需要反覆迭代,有助於提升運算效率。
這項技術的突破,也與北京大學人工智慧研究院研究員孫仲團隊的研究成果有關。該團隊於2025年10月在《自然電子學》(Nature Electronics)發表研究,將模擬計算精度提升至千萬分之一量級,單次矩陣方程求解速度較先進GPU快約3個數量級,能效比提升約2個數量級。
在實際應用方面,AX100已針對三大領域進行測試。在AI模型訓練方面,透過二階最佳化方案,Autoencoder模型訓練更新消耗減少92%,Transformer模型則減少56%;在具身智能領域,機器人運動控制與規劃演算法提速150%至500%,三維重建及SLAM即時定位建圖核心演算法提速200%至500%。
至於無線通信應用,針對128×128規模的信道格拉姆矩陣,AX100相較現有數位ASIC晶片與GPU,等效吞吐量提升20至207倍,等效能效提升27.6至61.3倍。
報導指出,AX100不依賴先進半導體製程,採用成熟製程即可生產,有利於降低製造門檻並實現供應鏈自主可控。向銳認為,這項技術有望為晶片產業開創不同於傳統GPU的運算路徑,也讓中國企業有機會參與定義新一代計算架構。